Pascal Mayer: «La realidad es menos lineal de lo que sugieren los relatos sobre tecnologías que tuvieron éxito»

CULTURA
«Una tecnología puede ser científicamente correcta incluso cuando la organización que la desarrolla fracasa comercialmente», asegura el Premio Princesa de Asturias de Investigación Científica y Técnica
19 oct 2026 . Actualizado a las 14:48 h.El trabajo de Pascal Mayer ha contribuido al desarrollo de nuevas tecnologías para el estudio del ADN, con aplicaciones en la investigación científica y biomédica. En esta entrevista, el Premio Princesa de Asturias de Investigación Científica y Técnica profundiza en su trayectoria científica y explica las posibilidades que abre la secuenciación del ADN.
—Su trabajo está estrechamente vinculado al desarrollo de tecnologías de amplificación y análisis del ADN. ¿Qué limitaciones técnicas de las primeras generaciones de PCR y secuenciación considera que fueron las más decisivas para moldear el desarrollo posterior de la genómica?
—La principal limitación era la escala. En los años 90, la secuenciación ya estaba automatizada, pero cada fragmento de ADN seguía siendo esencialmente un experimento individual. Preparar clones, manipular muestras y leer secuencias una tras otra hacía que la secuenciación del genoma completo fuera extremadamente lenta y costosa.
El cambio conceptual fue dejar de pensar en términos de una muestra de ADN por tubo y procesar millones de moléculas de ADN en paralelo sobre una superficie. Ese fue el origen de lo que llamamos secuenciación por colonia (o conglomerado) de ADN. Una vez que millones de estas colonias pudieron crearse simultáneamente mediante PCR en una superficie (lo llamé incorrectamente PCR en fase sólida) y analizarse simultáneamente, la secuenciación podría volverse masivamente paralela. Un aspecto importante de este enfoque es que desacopla el paso enzimológico lento de incorporación de nucleótidos (que tarda varios minutos) del paso rápido de detección fluorescente usando cámaras CCD (segundos por adquisición de imagen): en un primer paso, las colonias pueden analizarse simultáneamente en cuestión de minutos, sea cual sea su número (millones o incluso miles de millones), y luego se pueden adquirir muchas imágenes una tras otra en un tiempo total similar.
—En la amplificación del ADN, la fidelidad de la polimerasa es fundamental. Experimentalmente, ¿cómo se pueden equilibrar la fidelidad, la procesividad y la velocidad de síntesis, y qué compensaciones aún existen entre estas propiedades?
—No existe un óptimo universal. Una polimerasa debe ser seleccionada u optimizada por bioingeniería (como se hizo en Solexa) para la aplicación. La fidelidad, velocidad, procesividad, tolerancia a nucleótidos modificados y compatibilidad con el entorno de reacción pueden influir en diferentes direcciones.
Para la secuenciación, el punto importante no es necesariamente optimizar una propiedad de forma aislada, sino optimizar el sistema completo: polimerasa, química de nucleótidos, amplificación, imagen y análisis de señales.
—¿Qué fuentes de error considera actualmente más relevantes en la secuenciación de alto rendimiento: errores introducidos durante la preparación de la biblioteca, durante la amplificación o errores inherentes a la propia plataforma de secuenciación?
—Los tres contribuyen, y su importancia relativa depende de la aplicación. La preparación de la biblioteca puede introducir sesgo de muestreo, la amplificación puede crear errores o distorsionar la representación, y el sistema de química de secuenciación y procesamiento de señales tiene sus propios modos de error característicos.
La lección importante es que la secuenciación no es simplemente «leer ADN». Es una cadena de mediciones físicas, químicas y computacionales, y la fiabilidad del resultado final depende de toda la cadena.
—Cuando se trabaja con cantidades extremadamente pequeñas de ADN, ¿cómo se puede distinguir una variante biológica genuina de un artefacto causado por amplificación, degradación de muestras o contaminación?
—La idea central es la replicación y la redundancia. La información biológica genuina debe observarse repetidamente e independientemente, mientras que muchos artefactos surgen solo una vez.
Hoy en día esto puede implicar códigos de barras moleculares, amplificación independiente, profundidad de secuenciación muy alta, comparación con controles y modelado estadístico del error de fondo. Además, algunos métodos de amplificación lineal que no propaguen errores pueden ayudar. Pero en general, cuanto menor es la cantidad original de ADN, más importante se vuelve el diseño experimental.
Pero esto también apunta a una cuestión más profunda que la secuenciación ha hecho cada vez más visible: ¿qué queremos decir exactamente con «el genoma de un organismo»? Incluso las células derivadas de una sola célula por división celular no son perfectamente idénticas a nivel genético. Las mutaciones surgen durante la replicación del ADN, y esto parece ser una propiedad biológica conservada: por las tasas de mutación reportadas durante la replicación del genoma, parece que, sea cual sea el tamaño del genoma de un organismo, desde virus hasta mamíferos, normalmente hay 10 mutaciones (desde ligeramente menos de 1 hasta algo más de 100) por replicación genómica. Los organismos multicelulares, así como los microbiomas, son por tanto mosaicos de células, cada una con genomas ligeramente diferentes. Los elementos genéticos móviles y las integraciones virales pueden añadir más variación a lo largo de la vida.
Así que, una vez que los errores técnicos de secuenciación se reducen a niveles extremadamente bajos, la incertidumbre, dicho de forma más adecuada, la variabilidad, proviene cada vez más de la biología en sí misma que del instrumento. En algún momento, la cuestión sobre una secuencia genómica ya no es simplemente «¿de qué especie?», sino «¿de qué célula de qué individuo en qué momento y en qué entorno?»
—La secuenciación del ADN antiguo presenta desafíos particulares relacionados con la fragmentación y el daño molecular. ¿Qué patrones de daño son especialmente informativos para autenticar una muestra y cómo distinguirlos de los errores de secuenciación?
—El ADN antiguo no es mi campo de especialización, pero por lo que he podido entender de algunas lecturas, el principio general es muy elegante: el ADN antiguo auténtico lleva firmas moleculares características de edad y degradación, incluyendo fragmentación y patrones reproducibles de modificación de bases cerca de los extremos de los fragmentos. Estos patrones pueden ayudar a distinguir moléculas genuinamente antiguas de artefactos modernos de contaminación y secuenciación.
—En diagnóstico molecular, una mutación puede estar presente solo en una proporción muy pequeña de células. ¿Qué estrategias se pueden usar para detectar variantes de muy baja frecuencia sin aumentar inaceptablemente la tasa de falsos positivos?
—De nuevo, la redundancia es esencial. Una secuenciación muy profunda puede detectar variantes raras, pero la profundidad por sí sola no es suficiente porque los errores también se amplifican.
Por tanto, los enfoques modernos intentan identificar las moléculas originales de ADN individualmente, por ejemplo mediante identificadores moleculares, y se preguntan si la misma variante se observa de forma independiente en múltiples moléculas. La estadística entonces se vuelve tan importante como la química.
También debe considerarse el mosaicismo. Algunas enfermedades pueden resultar de una mutación que surge durante la embriogénesis y que solo está presente en un tejido u órgano concreto, a veces solo en una subparte de él, y por lo tanto puede permanecer indetectable en pruebas genéticas basadas en muestras de sangre o muestras bucales que resulten en «falsos verdaderos negativos». Y por las mismas razones, algunos «falsos verdaderos positivos» pueden detectarse en la muestra sin estar presentes en el órgano de origen de la enfermedad.
—¿Qué papel juegan actualmente los métodos de secuenciación de lectura larga en comparación con las tecnologías de lectura corta para resolver regiones repetitivas, variantes estructurales y haplotipos complejos?
—De nuevo, este no es mi campo de especialización, pero puedo decir que son muy complementarios.
Las tecnologías de lectura corta siguen siendo extraordinariamente potentes cuando se necesita una secuencia a gran escala y un rendimiento muy alto, como en genómica ecológica, microbiomática y de poblaciones y genética, genómica del cáncer, y más generalmente, cada vez el conocimiento de la variabilidad es más importante que el conocimiento preciso de detalles específicos. Las lecturas largas son especialmente útiles para reconstruir fácilmente estructuras genómicas a largo alcance, regiones repetitivas, reestructuraciones estructurales y haplotipos.
El campo combina cada vez más tecnologías en lugar de esperar que una sola plataforma resuelva todas las cuestiones biológicas.
—Se ha propuesto la amplificación isotérmica como alternativa a la PCR para ciertas aplicaciones. ¿En qué escenarios ofrece ventajas reales y cuáles son sus principales limitaciones en comparación con la PCR convencional?
—La amplificación isotérmica tiene la gran ventaja de la simplicidad: la amplificación puede proceder a una sola temperatura, reduciendo los requisitos de instrumentación. Algunos métodos de amplificación isotérmica también tienen la ventaja de no propagar errores de incorporación de nucleótidos, lo que puede ser muy útil para la secuenciación de células individuales. Dicho esto, un primer método de amplificación lineal podría utilizarse como primer paso en la preparación de muestras celulares para generar plantillas para la posterior generación de colonias de ADN basadas en PCR, y la redundancia permitiría eliminar fácilmente los errores originados en ambos pasos de amplificación.
La amplificación isotérmica está históricamente cercana a mi propio trabajo. En Manteia desarrollamos la amplificación isotérmica directamente sobre una superficie sólida, y se presentó una patente sobre ese enfoque en 2000. Curiosamente, más tarde volvimos a un termociclo más complicado durante un tiempo, algo que ahora considero un falso rastro.
Más tarde trabajé en otro método de amplificación isotérmica, denominado ICLEDA, que también puede usarse para computación lógica y neuronal basada en ADN.
—¿Qué avances considera necesarios para que la secuenciación directa de moléculas individuales alcance su máximo potencial en investigación y diagnóstico?
—De nuevo, este no es mi campo de especialización, pero puedo decir que los retos centrales son la relación señal-ruido, la precisión, la robustez, el rendimiento y el coste.
La secuenciación de molécula única es conceptualmente atractiva porque evita la amplificación, pero la amplificación también tiene una ventaja física importante: crea muchas copias idénticas de la misma molécula y, por tanto, amplifica la señal. Esa fue precisamente la razón por la que las colonias de ADN fueron tan útiles: convertimos una molécula casi invisible en un cúmulo microscópico que contenía cientos o miles de copias que podían detectarse de forma muy fiable y rápida.
—En una muestra biológica compleja, ¿cómo afecta la heterogeneidad molecular —por ejemplo, diferentes poblaciones celulares o diferentes alelos— a la interpretación de los datos de secuenciación?
—Profundamente. Los sistemas biológicos son heterogéneos por naturaleza.
Por tanto, un resultado de secuenciación de un tejido puede representar un promedio sobre muchas poblaciones celulares, estados y variantes genéticas diferentes. Tecnologías como la secuenciación de células individuales han comenzado a revelar cuánta información puede desaparecer cuando se promedia todo entre sí. Y también ocurre lo contrario: una secuencia celular única no representa la diversidad de células presentes en un órgano, un organismo o una población de células y microorganismos.
En muchos sentidos, la secuenciación nos ha enseñado que la biología es, en efecto, tan compleja como se puede inferir o imaginar a partir de conocimientos biológicos básicos. Así, tener acceso hoy a la heterogeneidad molecular abre nuevas vías para entender la biología que quizá no puedan explicarse por la históricamente ingenua visión de «un organismo-un genoma-un gen-una función». La heterogeneidad puede llevar a una mayor robustez frente al estrés sistémico molecular y, por tanto, puede contribuir a explicar el desarrollo de la resistencia a los fármacos y por qué algunos fármacos funcionarían por debajo de un órgano en comparación con un cultivo celular clonal.
—¿Hasta qué punto cree que la precisión de las tecnologías actuales nos permite pasar de identificar correlaciones genómicas a establecer relaciones causales entre una variante genética y un fenotipo?
—La precisión de la secuenciación ya no es el principal obstáculo, especialmente desde el punto de vista de la heterogeneidad biológica.
El problema más difícil es la causalidad biológica. Una variante puede correlacionarse con un fenotipo sin ser suficiente para causarlo, y las enfermedades comunes suelen implicar que muchos factores genéticos y ambientales actúan juntos, incluida la heterogeneidad genética.
La revolución de la secuenciación ha hecho posible ver esta complejidad con una resolución sin precedentes. Entenderla e intervenir en ella es ahora el problema más difícil. Esto es en lo que estoy trabajando actualmente a través de terapias pleiomoleculares: composiciones químicas altamente diversas diseñadas para actuar a través de múltiples interacciones moleculares coordinadas a través de un sistema biológico.
—¿Qué problemas matemáticos y bioinformáticos siguen siendo particularmente difíciles de resolver al analizar grandes cantidades de datos genómicos?
—La cantidad de datos ya no es el único desafío. El problema más profundo es extraer significado biológico de ello.
Podemos medir millones de diferencias genéticas, niveles de expresión o estados celulares, pero distinguir relaciones causales de correlaciones, entender las interacciones entre variables y conectar información molecular con fenotipos complejos siguen siendo problemas extremadamente difíciles. Los algoritmos basados en IA pueden formar parte de la solución. Esto es algo que ya habíamos empezado a explorar en Manteia, donde reclutamos a Jean-Michel Leroux, un experto en aprendizaje automático del Watson Research Center de IBM.
En cierto modo, nos hemos vuelto mucho mejores midiendo la biología que entendiéndola. Esta línea de pensamiento me ha llevado ahora a combinar datos experimentales pragmáticos con descubrimientos terapéuticos guiados por IA: medimos el resultado biológico producido por composiciones pleiomoleculares, permitimos que los algoritmos aprendan de esos resultados y proponemos iterativamente composiciones pleiomoleculares mejoradas.
—Si tuviera que identificar un único cuello de botella tecnológico que actualmente impide el próximo gran salto adelante en genómica —química, instrumentación, bioinformática o preparación de muestras—, ¿cuál sería y por qué?
—No estoy seguro de que el principal cuello de botella siga siendo la tecnología de secuenciación en sí.
El extraordinario éxito de la NGS ha cambiado el problema. Ahora podemos generar enormes cantidades de información molecular. La pregunta difícil es qué hacer con esa información en sistemas biológicos complejos.
Para mí, la siguiente frontera no es simplemente leer la biología con mayor precisión, sino aprender a actuar sobre la complejidad biológica. Ese es también el problema científico postgenómico que ahora intento abordar en Alphanosos con pleiomoleculares.
—¿Cuál era el problema original que intentaba resolver cuando se le ocurrió la idea que finalmente se convirtió en secuenciación de nueva generación?
—Inicialmente no se trataba de un proyecto llamado «secuenciación de nueva generación»; esa expresión ni siquiera existía.
A mediados de los años 90, la secuenciación del ADN seguía siendo engorrosa. El Proyecto Genoma Humano requería enormes recursos porque primero había que clonar, manipular y analizar fragmentos individuales de ADN. Una sola secuencia estaba esencialmente asociada a una muestra física.
Tenía una formación inusual que combinaba biología molecular, física de polímeros, microscopía de fluorescencia, electroforesis de ADN, instrumentación, matemáticas y programación informática. Esa combinación resultó ser importante.
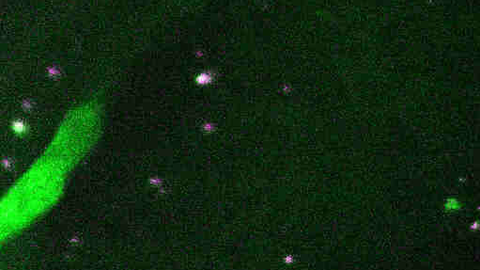
Durante el verano de 1996, empecé a preguntarme si el ADN podía organizarse en una superficie de manera análoga a las colonias bacterianas: partir de moléculas individuales de ADN, amplificar cada molécula localmente y obtener colonias microscópicas que contenían muchas copias idénticas.
Eso crearía una matriz de ADN autoformable.
El paso conceptual importante era que ya no era necesario fabricar millones de muestras individuales. La amplificación en la superficie sólida de cada molécula de ADN individual crearía la micromatriz de varios millones de muestras.
—¿Hubo algún momento en particular en el que se dio cuenta de que esto podía transformar la secuenciación del ADN?
—Sí, porque una vez que imaginas millones de colonias de ADN independientes en una lámina de microscopio, el potencial se vuelve bastante evidente.
Cada colonia contiene cientos o miles de copias idénticas de una molécula de ADN original. Por ello, produce suficiente señal fluorescente para medirse fácilmente con microscopía de epifluorescencia. Y se pueden observar millones de colonias en paralelo con una cámara CCD.
De repente, la unidad de experimentación cambia. En lugar de hacer un solo experimento de secuenciación con una muestra de ADN, puedes potencialmente realizar millones de reacciones de secuenciación simultáneamente con esencialmente la misma manipulación.
De ahí viene el enorme paralelismo.
Laurent Farinelli y yo comenzamos a desarrollar esto experimentalmente en el instituto de investigación biomédica de Glampo en Ginebra a finales de 1996. Las primeras imágenes de colonias de ADN en láminas de microscopio se obtuvieron en enero de 1997, y las primeras patentes sobre colonias de ADN y solicitudes de secuenciación se presentaron el 1 de abril de 1997.
—¿Fue uno de esos descubrimientos en los que todo funciona de inmediato?
—Absolutamente no.
La historia es mucho menos lineal de lo que suelen sugerir los relatos retrospectivos de tecnologías exitosas.
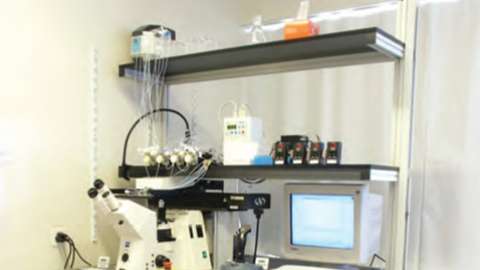
Tuvimos periodos de auténtica emoción, pero también cambios institucionales, cambios de propietario, cambios de estrategia, recursos limitados y callejones sin salida técnicos. En Manteia éramos un equipo multidisciplinar que intentaba ensamblar química de amplificación, química de secuenciación, microscopía, microfluídica, análisis de imágenes y software en un sistema funcional.
Para 2003, teníamos datos reales de secuenciación experimental, pero aún no la robustez ni la duración de lectura que necesitábamos. Visitamos Solexa en Cambridge. Su equipo tenía una excelente experiencia en química, enzimología y tecnología láser, mientras que nosotros disponíamos de la plataforma de amplificación de colonias de ADN, imagen, análisis de imágenes y otros componentes tecnológicos, en particular protocolos y conceptos de preparación de muestras que permitían un conjunto ampliado de aplicaciones, desde genómica hasta secuenciación genómica y genotipado a nivel genómico, y estábamos siguiendo un camino hacia una «tarjeta genómica personal» en farmacogenética. La complementariedad era evidente para nosotros.
Pero Manteia se quedó sin tiempo ni dinero. Serono decidió liquidar la empresa y vender la tecnología a Solexa.
Así que la historia contiene tanto éxito científico como fracaso emprendedor. Una tecnología puede ser científicamente correcta incluso cuando la organización que la desarrolla fracasa comercialmente.
—¿Cómo llegó la tecnología Manteia a formar parte de la secuenciación de Illumina?
—Solexa combinó su química de secuenciación con tecnologías adquiridas de Manteia y posteriormente con tecnologías de Lynx. La plataforma resultante se convirtió en el Analizador de Genomas Solexa.
Illumina adquirió Solexa en 2007, y esa línea tecnológica se convirtió en la base de lo que ahora es una de las plataformas de secuenciación dominantes en el mundo.
Sin embargo, creo que es importante no contar esto como la historia de un solo inventor. Hubo muchos colaboradores. Laurent Farinelli fue especialmente importante en nuestro trabajo inicial, y muchos científicos e ingenieros en Ginebra, Cambridge y más tarde en otros lugares hicieron contribuciones esenciales.
Cuando recibo premios como el Premio Princesa de Asturias, los veo en parte como reconocimiento a lo que me gusta llamar las «raíces léminicas» de la historia de NGS: los equipos alrededor de Ginebra y el Lago de Ginebra que contribuyeron a esta línea tecnológica.
—¿Qué es lo que más le ha sorprendido del impacto de la secuenciación de nueva generación?
—Probablemente la magnitud de su impacto.
La consecuencia más evidente fue económica. El primer genoma humano requirió años de trabajo y miles de millones de dólares; hoy en día un genoma humano puede secuenciarse en aproximadamente un día a un coste medido en cientos de dólares.
Pero las consecuencias van mucho más allá.
El NGS cambió la medicina oncológica, el diagnóstico de enfermedades raras, la vigilancia de enfermedades infecciosas, la microbiología, la biología evolutiva, la ecología y muchas otras áreas. Durante la COVID-19, por ejemplo, la secuenciación rápida permitió identificar y distribuir el nuevo genoma del coronavirus por todo el mundo de forma extraordinariamente rápida.
Quizá aún más fundamentalmente, NGS cambió nuestra representación de la biología.
—¿Qué quiere decir con que la secuenciación cambió nuestra representación de la biología?
—Antes de la genómica, la medicina solía esperar que las enfermedades complejas pudieran reducirse finalmente a mecanismos relativamente simples: identificar el gen importante, identificar la proteína correspondiente, encontrar el objetivo molecular adecuado y diseñar un fármaco contra él.
A veces eso funciona de maravilla.
Pero la genómica también nos ha demostrado que muchas enfermedades comunes no son así. Puede haber cientos o miles de variantes genéticas, cada una aportando una pequeña cantidad; diferentes pacientes pueden llegar a fenotipos similares de enfermedades por distintas vías biológicas; la regulación génica, el ambiente, el estado celular y las redes moleculares interactúan.
NGS no creó esa complejidad. Hizo visible la complejidad.
Eso tiene consecuencias profundas para la medicina.
—Hay alguna conexión entre esa lección de genómica y su trabajo actual en Alphanosos?
—Una muy directa. La NGS ayudó a revelar que muchas enfermedades son problemas sistémicos. Sin embargo, la farmacología suele comenzar seleccionando un objetivo molecular y buscando una molécula que actúe con fuerza sobre ese objetivo.
Cada vez sentía más que había una desconexión entre la complejidad revelada por la genómica y la simplicidad de la estrategia terapéutica que utilizábamos para abordarlo.
Este es uno de los orígenes intelectuales de Alphanosos.
En lugar de preguntarnos: «¿Qué molécula debería alcanzar este objetivo predefinido?», podemos preguntarnos: «¿Qué resultado biológico queremos obtener?» Luego usamos experimentos iterativos guiados por nuestra IA propietaria para descubrir combinaciones de moléculas que, en conjunto, mueven al sistema biológico hacia ese resultado.
A esto lo llamamos composiciones pleiomoleculares: múltiples componentes pueden ejercer efectos coordinados en varios puntos del sistema biológico.
Por eso, para mí, existe una continuidad conceptual entre NGS y Alphanosos. La secuenciación de nueva generación nos dio una forma radicalmente mejor de observar la complejidad biológica. Alphanosos es un intento de desarrollar una nueva forma de actuar sobre esa complejidad.
En ambos casos, la pregunta subyacente es la misma: ¿cómo diseñamos tecnologías que respeten la escala y complejidad de la biología en lugar de forzar la biología a las limitaciones de nuestra tecnología?